Dizine eklenebilirlik kararı
Bu sayfa gerçekten dizine eklenebilir mi — eklenemiyorsa hangi dosyayı açmanız gerektiği.
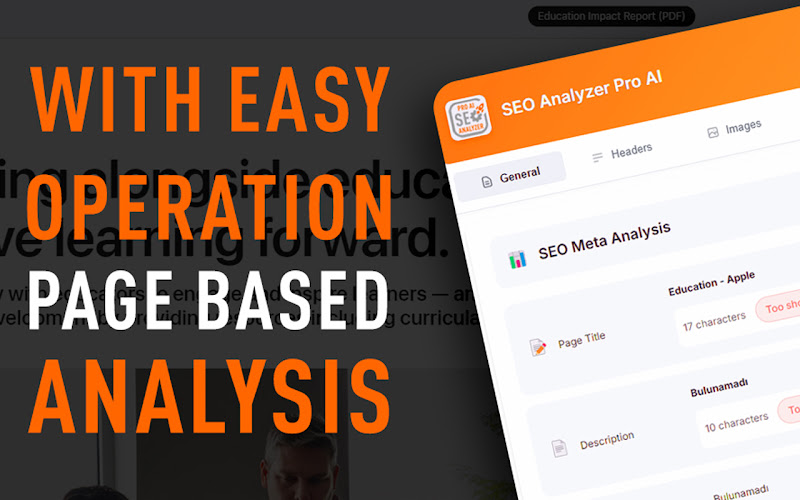
Açık olduğunuz sayfanın tam bir SEO analizini yapar, sonra tek tıkla sitenin geri kalanını tarar. Tek sayfaya bakarak göremeyeceğiniz şeyleri bulur: tekrar eden başlıklar, hiçbir yerden link almayan sayfalar ve sayfaları sessizce Google'ın dışında bırakan teknik SEO sorunları. Her şey tarayıcınızda çalışır; sayfalarınız hiçbir yere yüklenmez.
Sık karıştırılan iki kavram; ikisi farklı soruya cevap veriyor.
SEO analizi, bir sayfanın ya da sitenin arama motorları tarafından bulunmasını, okunmasını ve sıralanmasını etkileyen her şeyin denetlenmesidir: başlık ve açıklama, başlık hiyerarşisi, iç linkler, görseller, yapısal veri, sayfa hızı ve sayfanın dizine eklenmeye izinli olup olmadığı. Site analizi ise aynı denetimleri tüm sayfalara yayar ve yalnızca site düzeyinde görünen sorunları ekler — iki sayfanın aynı başlığı paylaşması gibi.
Teknik SEO, metninizle hiç ilgilenmeyen kısımdır: arama motoru bu sayfaya ulaşabiliyor mu, dizine eklemesine izin var mı ve sitenin yapısı buna yardım mı ediyor engel mi oluyor. Robots kuralları, canonical etiketi, HTTP durum kodları, yönlendirmeler, site haritası, tıklama derinliği ve Core Web Vitals bu başlığın altındadır.
Sayfayı Chrome'da açın, üzerinde ücretsiz SEO analizi yapan bir eklenti çalıştırın ve sıralanmış sorun listesini okuyun. Site geneli için iç linkleri tarayan ve sayfaları birbiriyle karşılaştıran bir araç gerekir — tekrar eden başlıkları, öksüz sayfaları ve tıklama derinliğini ancak öyle görebilirsiniz. Crawlhive ikisini de ücretsiz yapar, hiçbir şey yüklemeden.
Kurulum yok, proje oluşturmak yok, adres yapıştırmak yok. Baktığınız sayfa, denetlenen sayfadır.
Kendi siteniz ya da rakibinizinki — analiz ikisinde de aynı çalışır.
Ya da Ctrl+Shift+S. Google ile bir kez giriş yapın; tek hesap tüm eklentilerimizde geçerli.
100 üzerinden tek bir sayı; her sorun size kaç puana mal olduğuyla birlikte sıralanır.
Tek tık sitenin geri kalanını tarar ve tek sayfanın gösteremeyeceğini bulur.
Müşteri e-postası için Markdown, kendi aracınız için JSON, tablo için CSV.
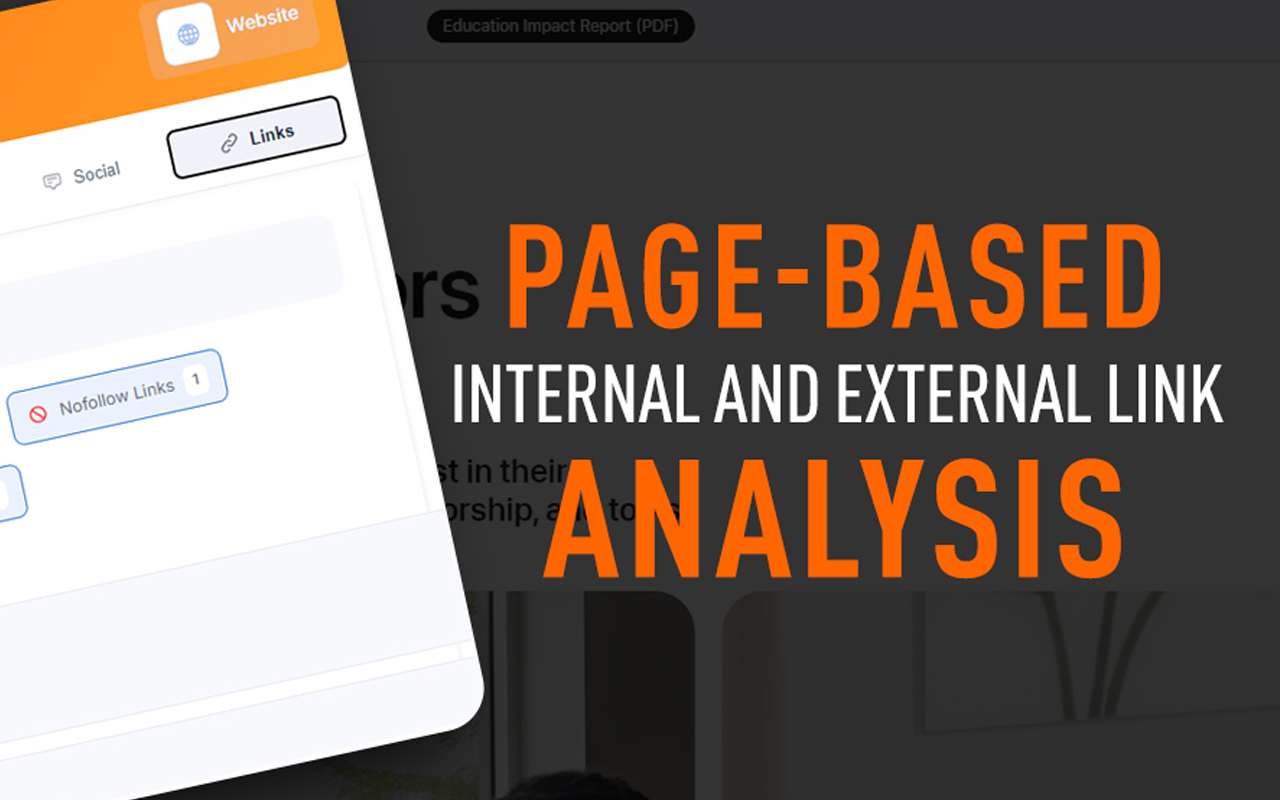
Düzgün bir web sitesi analizi tek adresten geniş bakmak zorundadır, çünkü en pahalı SEO sorunları tek sayfadan görünmez. Aynı başlıkla yarışan iki sayfa. Hiçbir yerin link vermediği bir sayfa. Ana sayfadan beş tık uzakta, tarayıcıların pek uğramadığı bir bölüm. Bunların hiçbirini tek adrese bakarak göremezsiniz.
Tek tık, bulunduğunuz sayfadaki iç linkleri takip eder ve her sayfanın HTML'ini okur. Sonuç sitenizin link haritası — üstelik sayfaların kendisi dışında tek bir ek istek atılmadan çıkarılır.
Sınırlar bilerek dar: yalnızca aynı origin, robots.txt'de kapalı
yollar istek atılmadan atlanıyor, en fazla 40 sayfa, aynı anda üç istek ve
yıkıcı görünen adresler — çıkış, silme, ödeme — hiç ellenmiyor. Sunucu sizin;
tarama istediğiniz an durdurulabiliyor.
Sekiz panel, tek tık, hiçbir sayfa tarayıcınızdan çıkmıyor.
Bu sayfa gerçekten dizine eklenebilir mi — eklenemiyorsa hangi dosyayı açmanız gerektiği.
Tekrar eden başlık, öksüz sayfa, tıklama derinliği, kırık iç link, site geneli noindex.
LCP, CLS, TTFB ve FCP; ilk boyamayı geciktiren her dosyayla birlikte.
H1-H6 yapısı, seviye atlama uyarıları ve tekrar denetimi.
Alt metni olmayanlar, lazy yükleme ve çizildiği kutudan çok daha büyük dosyalar.
Google'ın gerçekten istediği alanlara göre doğrulanır — sadece "bulundu" demez.
Kendine referans, tekrarlı kodlar, geçersiz kodlar ve göreli adresler.
Markdown, JSON ve CSV — müşteri e-postasına ya da tabloya hazır.
Cevabın sayfanın kendisinde görünmediği dört durum.
Test ortamından canlıya geçen bir noindex, SEO'nun en pahalı
hatasıdır — çünkü sayfada hiçbir şey bunu göstermez. Haftalarca orada durur ve
trafik sessizce erir. Her yayından sonra otuz saniyelik kontrol, en ucuz
sigortadır.
Ajans denetimleri hep aynı bulgularla başlar: tekrar eden başlıklar, eksik H1'ler, öksüz sayfalar, kırık iç linkler. Siteyi tarayıp raporu Markdown olarak dışa aktarın; ilk taslak kendiliğinden yazılmış olur.
İçeriği yeniden yazmadan önce sıkıcı olanlara bakın: dizine eklenebilir mi, canonical başka sayfayı mı gösteriyor, kaç iç link alıyor, kaç tık derinde. "Neredeyse hiçbir yer link vermiyor" şaşırtıcı derecede sık çıkan cevaptır.
Yapısal verisi, başlık düzeni, hreflang kurulumu, sitenin nasıl linklendiği. Hepsi zaten size sunduğu HTML'in içinde — giriş yok, araç yok, izin yok.
Aynı denetim, neden açtığınıza göre farklı okunuyor.
Dizine eklenebilirlik kararı ve tarama bulguları, teknik bir denetimin yaşadığı iki şeydir. Her şey dışa aktarılabildiği için rapor ekran görüntüsü olmaktan çıkıp teslim edilebilir bir çıktıya dönüşüyor.
Yayın sonrası otuz saniyelik kontrol: noindex gitti mi, canonical
bozuldu mu, H1 yalnızca JavaScript çalıştıktan sonra mı geliyor. Üç hafta
sonra trafik grafiğinden öğrenmekten ucuz.
Müşteri için hazırlanan site analizi genelde tekrar eden başlıklar, eksik H1'ler ve öksüz sayfalarla açılır. Tarayın, Markdown olarak alın, taslak hazır.
Kullanmak için terminolojiye gerek yok: bir puan, sıralı bir liste ve her düzeltmenin kaç puan getirdiği. Sayfa sıralanmıyorsa sıkıcı teknik sebepler önce eleniyor.
Ücretsiz eklentilerin çoğu baktığınız sayfayı okur ve orada durur.
| Tipik ücretsiz eklenti | Crawlhive | |
|---|---|---|
| Kapsam | Tek sayfa | Sayfa, ardından tüm site |
| Tekrar eden başlıklar | Göremez | Tarama sırasında bulunur |
| Öksüz sayfalar | Mümkün değil | Site haritası link haritasıyla karşılaştırılır |
| Tıklama derinliği | Mümkün değil | Başlangıç sayfanızdan ölçülür |
| X-Robots-Tag başlığı | Genelde atlanır | Meta robots ve robots.txt ile birlikte okunur |
| Arama önizlemesi | Karakter sayısı | Google'ın kendi yazı tipinde, piksel ölçümü |
| Core Web Vitals | Nadiren var | LCP, CLS, TTFB, FCP |
| Sayfalarınız nereye gidiyor | Çoğu zaman bir sunucuya | Hiçbir yere — yerinde okunur |
| Masaüstü uygulaması | Yok | Yok — tarayıcıda çalışır |
| Ücret | Sınırlı ücretsiz paket | Ücretsiz |
Taramayı izin istemeden mümkün kılan şey, okuyucunun sayfanın kendi
origin'inde çalışması. Aynı origin'e istek atmak için host izni gerekmiyor;
robots.txt, yanıt başlıkları ve site haritası bu yüzden okunabiliyor.
Açık yazmakta fayda var, çünkü bir SEO aracından en çok beklenen üç şey bunlar.
Sayfanızın ve sitenizin gerçekte ne içerdiğini okur: dizine eklenebilirlik, yapı, linkler, hız, yapısal veri — ve tek sayfanın gösteremediğini bulmak için siteyi tarar.
Sıralama takibi yok, backlink verisi yok, domain authority puanı yok, yapay zekâ tahmini yok. Bunlar üçüncü taraf veritabanı ve abonelik ister; bu araç kendi HTML'inizi okur.
Backlink ya da kelime sıralaması gerekiyorsa kendi indeksi olan ücretli bir platform gerekir — Ahrefs, Semrush ve Moz tam olarak bunun için var. Crawlhive işin diğer yarısını, yani kendiniz doğrulayabileceğiniz yarısını kapsıyor ve bunu tek bir sayfa yüklemeden yapıyor.
Denetlediğiniz sayfalar bulundukları yerde okunur, tarayıcınızdan çıkmaz.
Okuyucu zaten açık olan sekmenin içinde çalışır. Hiçbir sayfa içeriği bir yere gönderilmez.
Atılan tek istekler denetlediğiniz siteye — robots.txt'sine, site haritasına, kendi sayfalarına.
Yalnızca ad, e-posta ve profil resmi; tek hesap tüm eklentilerimizde geçerli olsun diye.
Takip betiği yok, reklam yok; gezinmenizle ilgili hiçbir şey bize ya da başkasına ulaşmaz.
Evet. Ücretli paket, kredi sistemi ya da aylık sayfa sınırı yok. Google ile giriş yapmanız gerekiyor; tek hesap tüm eklentilerimizde geçerli.
Sayfayı açın, eklentiye tıklayın, puanı ve sıralanmış sorun listesini okuyun. Site geneli için Site sekmesini açıp taramayı başlatın — tekrar eden başlıklar, öksüz sayfalar ve tıklama derinliği oradan gelir.
Metninize değil, arama motorlarının sayfanıza ulaşıp okuyup dizine ekleyebilmesine bakar: dizine eklenebilirlik, canonical, robots kuralları, durum kodları, site yapısı ve hız.
Chrome'da açabildiğiniz her sayfada, sahibi olmadığınız siteler dahil. Tarayıcının kendi hata sayfalarında ve chrome:// adreslerinde çalışmaz; Chrome bunu her eklentiye kapatır.
Her çalıştırmada en fazla 40 sayfa, yalnızca aynı origin, aynı anda üç istek. robots.txt'de kapalı yollar istek atılmadan atlanır ve tarama istediğiniz an durdurulabilir.
Hayır. Backlink verisi ve sıralama takibi üçüncü taraf indeks ve abonelik ister. Crawlhive sayfanızın ve sitenizin gerçekte ne içerdiğini okur.
Hayır. Sayfalar zaten açık olan sekmenin içinde okunur. Atılan tek istekler denetlenen siteye gider. Bize ulaşan tek şey giriş sırasındaki hesap kimliğiniz.
Evet — müşteri e-postasına yapıştırmak için Markdown, kendi aracınız için JSON, linkler, görseller ve tarama sonuçları için CSV.
"Dizine eklendi" ile "dizine eklenebilir" farklı sorulardır. Crawlhive ikincisini yanıtlar: sayfada, başlıklarında ya da robots.txt'de engelleyen bir şey var mı. Google'ın gerçekten eklediğini görmek için Search Console'a bakın.
İki listeyi karşılaştırın: site haritanızdaki her adres ve iç linkleri takip ederek ulaşılabilen her adres. Birincide olup ikincide olmayanlar öksüzdür. Tarama iki listeyi de zaten çıkarır.
Evet. Analiz, her ziyaretçinin aldığı HTML'i okur; açabildiğiniz her sitede çalışır — yapısal veri, başlıklar, hreflang ve iç link yapısı dahil.
Chrome ve diğer Chromium tarayıcılarında: Edge, Brave ve Opera. Arayüz 49 dilde, tarayıcı dilinizi takip eder.
Google site analizi denince akla iki şey gelir: Search Console verisi ve sayfanın kendi içeriği. Search Console geçmiş performansı gösterir; Crawlhive ise sayfanın şu anki halini okur — dizine eklenebilir mi, başlık kaç piksel, hangi sayfalar öksüz. İkisi birbirini tamamlar.
Evet, sıralanmış sorun listesi zaten bir kontrol listesidir. Her satır kaç puana mal olduğunu söyler, dolayısıyla neyi önce düzelteceğiniz tartışma konusu olmaktan çıkar.
Sayıyı not gibi değil, yapılacaklar listesi gibi görün. 100 üzerinden puan yalnızca altındaki her sorun size kaç puana mal olduğunu söylediği için işe yarar. Düzeltip tekrar çalıştırın, sayı değişimin işe yarayıp yaramadığını söyler.
Hızlı bir teknik kontrol ve küçük bir tarama için aynı işi masaüstü uygulaması ya da abonelik olmadan yapar. On binlerce adres taramak, backlink verisi ya da sıralama takibi için geçmez — onlar ayrı platformlar ister.
SEO tavsiyelerinin çoğu anahtar kelime ve içerikle başlar. O, görünen yarısı. Diğer yarısı ise bunların okunup okunmayacağına karar veriyor: bir tarayıcı sayfaya ulaşabiliyor mu, dizine eklemesine izin var mı ve sitenin yapısı o sayfayı öne mi çıkarıyor gömüyor mu. Aşağıda bunların her birini, pahalı sorunları önce bulan sırayla anlattım.
Her şeyden önce sayfanın aramada görünmeye uygun olup olmadığını netleştirin. Cevap hayırsa geri kalan her çaba boşa gider ve bu cevap sayfaya bakarak görünmez.
Bir sayfayı dizinin dışında tutabilecek üç ayrı mekanizma var ve yalnızca biri görüntüleyebildiğiniz HTML'de:
robots meta etiketi. Her SEO eklentisinin okuduğu şey. Buradaki bir noindex doğrudan "dizine ekleme" talimatıdır.X-Robots-Tag yanıt başlığı. Aynı işi yapar ama HTTP yanıtında taşınır — sayfa kaynağında görünmez ve düzenli olarak gözden kaçar.
Test ortamından canlıya taşınan bir noindex'in SEO'nun en pahalı
hatası olmasının sebebi tam olarak bu: sayfa gayet normal görünür, trafik
haftalar içinde erir ve kimse yanıt başlıklarına bakmayı akıl etmez.
robots.txt dizine eklemeyi değil taramayı yönetir ve kuralları
göründüğünden karmaşıktır. Aynı adrese birden fazla kural uyduğunda en uzun
eşleşme kazanır; eşit uzunlukta iki kural çelişirse Allow,
Disallow'u yener. Joker karakterler bunu gözle takip etmeyi
zorlaştırır.
Engellenmiş bir sayfa taranamaz, dolayısıyla üzerindeki noindex hiç
görülmez — bir sayfayı arama sonuçlarından kaldırmak için robots.txt'de
engellemenin yanlış yol olmasının sebebi budur. İki mekanizma farklı sorunları
çözüyor ve sürekli karıştırılıyor.
Bilinen tavsiye — başlığı 50-60 karakterde tutun — Google'ın farklı ölçtüğü bir şeyin kaba karşılığıdır. Sonuçlar piksel genişliğine göre kesilir ve karakterler eşit değildir: büyük harfle yazılmış ya da geniş harfler içeren bir başlık, karakter sayısının söylediğinden çok daha erken biter; dar harflerden oluşan bir başlık ise 60'ı rahatça geçer.
Kesme noktasını bilmenin tek yolu, Google'ın gerçekten kullandığı yazı tipinde gerçek genişliği ölçmektir. Küçük bir ayrıntı ama çağrınızın arama sonucunda görünmesiyle üç noktaya dönüşmesi arasındaki farkı belirliyor.
Yaygın kontrol "sayfada tam olarak bir H1 var mı" şeklindedir ve bilmeye değer, ama daha yararlı sinyal düzenin kendisidir. Seviye atlayan başlıklar — H2'den sonra doğrudan H4 — genelde sayfanın yapılandırılmak yerine biçimlendirildiğini gösterir ve belge artık kendi hiyerarşisini anlatmıyordur.
Tekrar eden başlıklar da önemlidir. İki aynı H2, çoğu zaman şablonun birleştirilmesi gereken bir bölümü tekrarladığı anlamına gelir ve sayfanın tasarlanarak değil birike birike büyüdüğünün güvenilir bir işaretidir.
Çoğu araç bir şema türünün algılandığını söyler. Kolay kısmı odur. Zengin sonuç alıp almayacağınızı belirleyen şey, zorunlu alanların dolu olup olmadığıdır — teklifi olmayan bir Product, işaretleme ne kadar doğru görünürse görünsün hiçbir zengin sonuç üretmez.
Yani işe yarar çıktı "Product bulundu" değil, "Product bulundu ama teklif yok, dolayısıyla zengin sonuç çıkmayacak" cümlesidir. Fark, kontrol etmenin bütün amacıdır.
Bir tarayıcının ilk geçişi, HTML'i sunucudan geldiği haliyle okur. Başlığınız, H1'iniz ya da canonical'ınız yalnızca JavaScript çalıştıktan sonra ortaya çıkıyorsa, o ilk okumada orada değildir. Google sonunda sayfayı işler ama işleme ikinci, daha yavaş ve daha az kesin bir adımdır.
Sunucunun gönderdiğiyle tarayıcının ulaştığı hali karşılaştırmak, sayfanızın hangi kısımlarının o ikinci geçişe bağlı olduğunu söyler. Dizine eklenmek için kritik olan her şey birincide olmalıdır.
Yukarıdakilerin hepsi tek bir adresle ilgili. Sıralamayı en çok değiştiren bulgular ise yapısaldır ve ancak siteye bir graf olarak bakınca görünür:
href düzeltmesiyle çözülüyor.Core Web Vitals belirsiz bir konuyu ölçülebilir üç şeye indirdi ve ikisi genelde sunucuya dokunmadan düzeltilebiliyor. LCP, en büyük görünür öğenin boyanma süresi — çoğunlukla bir hero görseli ya da boyamayı engelleyen bir stil dosyasının geciktirdiği bir başlık. CLS, sayfa yüklenirken düzenin ne kadar zıpladığı; neredeyse her zaman bir görsele ya da reklama yer ayrılmamış olmasından.
TTFB ise sunucuyu işaret eden ölçüdür ve diğerlerinden ayrı tutmakta fayda var: yavaş bir ilk bayt, diğer bütün metrikleri kötüleştirir ve hiçbir ön yüz çalışması bunu düzeltmez.
Her sitede kontrol etmeye değer bir israf var: çizildiği kutudan çok daha büyük sunulan görseller. 24 pikselde gösterilen 128 piksellik bir dosya, ziyaretçinin indirip hiç görmediği bayttır. Ekran yoğunluğu burada önemli — 2× ekranda 200 piksellik kutuya 400 piksellik dosya koymak israf değil, doğrusudur — ve vektörler muaftır, çünkü bir SVG'nin harcayacak çözünürlüğü yoktur.
Tam bir site denetimi çoğu site için üç ayda bir yapılacak iştir. Dizine eklenebilirlik kontrolü ise öyle değil: şablonlara dokunan her yayından sonra ve ani trafik kaybı yaşayan her sayfada çalıştırın. Saniyeler sürüyor ve en pahalıya mal olan hatayı yakalıyor.
Tam denetimi yaptığınızda şu sırayla düzeltin: dizine eklemeyi engelleyenler, sonra yapısal sorunlar (tekrar, öksüz, derinlik), sonra sayfa içi ayrıntılar, en son hız. Bu sıra bir zevk meselesi değil — dizine eklenemeyen bir sayfa daha hızlı bir LCP'den hiçbir şey kazanmaz.
Ücretsiz, sayfa sınırı yok ve denetlediğiniz hiçbir şey tarayıcınızdan çıkmıyor.
Crawlhive'ı Chrome'a Ekle — ÜcretsizCrawlhive bağımsız bir tarayıcı eklentisidir. Google ile bağlantılı değildir, onlar tarafından onaylanmamış ve desteklenmemektedir. Chrome, Google LLC'nin ticari markasıdır.
Yaptığımız her araç ücretsizdir ve doğrudan tarayıcınızda çalışır.
 Instagram Unfollow AI — Takip Etmeyenleri Bulma
Instagram'da sizi geri takip etmeyenleri bulur ve tek tek uğraşmadan, güvenli hızda takipten…
 WASendly — WhatsApp Rehber Dışa Aktarma
WhatsApp Web'deki kişileri ve grup üyelerini Excel, CSV ya da vCard olarak dışa aktarır…
 Followgap — Takipten Çıkanları Görme
Sizi takipten çıkanları tespit eder, geri takip etmeyenleri listeler ve seçtiklerinizi güvenli…
 FollowStack — Instagram Masaüstü Araçları
Bilgisayardan hikaye paylaşın, Reels indirin, takipçi değişimini izleyin. Instagram'ı…
 ChatGPT Speed Booster — ChatGPT Yavaş Çalışıyor Çözümü
Uzun sohbetlerde ChatGPT yavaşlıyorsa sebebi tarayıcının yüzlerce mesajı aynı anda çizmesi…
 WASendly — WhatsApp Toplu Mesaj Gönderme
WhatsApp Web üzerinden toplu mesaj gönderin. Excel listesi yükleyin, kişiselleştirin, güvenli…
 Instagram Follower Export Tool — Takipçi Listesi İndirme
Instagram takipçi ve takip listenizi tek tıkla Excel veya CSV olarak indirin. Beğeni ve yorum…
 IGFollow AI — Instagram Otomatik Takip
Hedef hesabın takipçilerini otomatik takip eder. Cinsiyet analizi, spam koruması, günlük limit…
 Backly — Instagram'da Toplu Takipten Çıkma
Instagram'da takip ettiklerinizi toplu olarak çıkarın: hızı siz belirlersiniz, korumak…
 ChatPilot — ChatGPT Sohbet Geçmişi Toplu Silme
ChatGPT kenar çubuğuna onay kutusu ekler; onlarca sohbeti seçip tek tıkla siler veya arşivler…
 X Unfollow AI — Twitter'da Takip Etmeyenleri Bulma
X (Twitter) hesabınızda sizi takip etmeyenleri listeler, seçtiklerinizi toplu takipten…
 PromptJolt — Yapay Zeka Prompt Yazma Yardımcısı
Yazdığınız kısa promptu tek tıkla net, yapılandırılmış bir yönergeye dönüştürür. ChatGPT…
 Instagram Auto Follow — Instagram Oto Takip Etme
Instagram'da otomatik takip etme aracı. Hedef hesabı seçin, gecikme ve günlük limiti…
 Extract AI — Mail Adresi Bulma
Bir web sayfasında açıkça yayınlanmış e-posta adreslerini saniyeler içinde bulur, tekrarları…
 Claude Speed Booster — Claude AI Yavaş Çalışıyor Çözümü
Uzun sohbetlerde Claude.ai yavaşlıyorsa sebebi tarayıcının yüzlerce mesajı aynı anda çizmesi…
 TikTok Unfollow AI — Toplu Takipten Çıkma
TikTok'ta sizi takip etmeyenleri görün, herkesi ya da seçtiklerinizi güvenli hızda toplu…
 FeedRank — Instagram Akış Sıralaması Değiştirme
Instagram ve TikTok akışını beğeni, yorum, görüntülenme ya da tarihe göre sıralar…
 Prompt Trove — Yapay Zeka Görsel Prompt
4.000+ hazır görsel promptu örnek görselleriyle listeler; beğendiğinizi ChatGPT, Gemini veya…
 Clearbox — Instagram Toplu Mesaj Silme
Instagram DM kutunuzdaki sohbetleri tek tek değil topluca siler; korumaya aldığınız…
 Numsift — WhatsApp Numara Sorgulama ve Doğrulama
Elinizdeki numara listesinin hangilerinde WhatsApp olduğunu toplu kontrol eder, ülkeye göre…
 Detechtor AI — Site Hangi Altyapıyı Kullanıyor?
Bir web sitesinin hangi altyapıyla kurulduğunu tek tıkla gösterir: WordPress mi, Shopify mi…
 ExportPal — ChatGPT Sohbet Dışa Aktarma
ChatGPT, Claude, Gemini ve DeepSeek sohbetlerinizi PDF, Word veya metin olarak indirin. Biçim…
 InkShot — Tam Sayfa Ekran Görüntüsü Alma
Bir web sayfasının tamamını kaydırarak tek görsele alır, üzerine ok, metin ve vurgu ekler…
 SignedRise — E-posta İmzası Oluşturma
Gmail, Outlook ve Yahoo için profesyonel e-posta imzasını birkaç dakikada hazırla; HTML…
 Clickaroo — Fare Tıklama Efekti ve İmleç Animasyonu
Ekran kaydı ve canlı yayında nereye tıkladığın görünsün diye imlecin altına animasyon ekler.
 Privacy Guard — WhatsApp Web Gizleme ve Kilitleme
WhatsApp Web'de sohbetleri bulanıklaştırır, ekranı şifreyle kilitler ve panik tuşuyla anında…